Transformer 不完全图解:一个 AI 工程师需要理解到多深?
- 约 28 分钟读完 - 全文 10932 字Transformer 不完全图解:一个 AI 工程师需要理解到多深?
做 AI 应用开发,不一定要会手推反向传播,但理解 Transformer 的基本工作原理非常有价值。这篇文章结合经典文章《The Illustrated Transformer》与《LLM 安全 | 大语言模型应用安全入门》中的图解,从零梳理我最常被人问到的几个核心问题。
一、为什么 AI 工程师需要懂 Transformer?
我自己是从 Java 后端转型到 AI 工程的,最初有个困惑:
「我只是调用 LLM API,为什么要懂 Transformer?」
后来在实际项目中发现,不懂底层会导致很多问题:
- 不知道 Token 是怎么切分的,导致成本估算偏差
- 不理解上下文窗口限制的本质,导致长文本处理方案选错
- 不明白 Attention 机制,做不好 RAG 和 Prompt 设计
- 不清楚自回归生成,理解不了为什么 LLM 会"胡编"
你不需要成为算法研究员,但需要知道模型在做什么、能力边界在哪里。
二、一句话理解 LLM:词语接龙预测器
如果你之前对 LLM 略有耳闻,很可能听过这个说法:
LLM 本质上是一个 Next Token Predictor(下一个 Token 预测器),也就是"词语接龙"。
但大多数解释到此为止。真正的问题是:它怎么知道下一个词该接什么?
答案可以简化成三步:
- 把文字变成数字:用 Embedding 把每个 Token 表示成向量
- 层层加工语义:用 Transformer 不断提炼上下文信息
- 输出概率分布:预测词表里每个 Token 出现的可能性,选最可能的那个
flowchart LR
    A["输入文本"] --> B["变成向量"]
    B --> C["多层 Transformer 加工"]
    C --> D["输出概率分布"]
    D --> E["选出下一个 Token"]

    style E fill:#fff4e1
三、从单词到向量:Embedding 是什么?
人类用字母表示单词,比如 C-A-T 表示"猫"。但神经网络只认识数字,所以我们需要把单词映射成词向量(word vector)。
例如,“cat” 可能被表示成这样一个向量:
[0.0074, 0.0030, -0.0105, 0.0742, …, 0.0002]这个向量的维度通常是 300、1000、1536,甚至像 GPT-3 那样达到 12,288 维。
3.1 词向量的神奇性质
在训练好的词向量空间里,含义相近的词会离得很近。比如 “cat” 附近会有 dog、kitten、pet。
更神奇的是,词向量还能做"语义计算":
biggest - big + small ≈ smallest
Paris - France + Germany ≈ Berlin
Swiss - Switzerland + Cambodia ≈ Cambodian
这种能力让模型不仅能"认识"词,还能在一定程度上"理解"词之间的关系。
3.2 词向量是怎么得到的?
早期的 word2vec 通过分析大量文本,让模型预测"一个词旁边常出现哪些词",从而把语义相近的词放到相近的位置。
现代 LLM 不再单独训练词向量,而是把 Embedding 层作为模型的一部分,端到端地训练。但核心思想没变:把离散的符号映射成连续的、有意义的向量。
四、Transformer 总览:数据是怎么流动的?
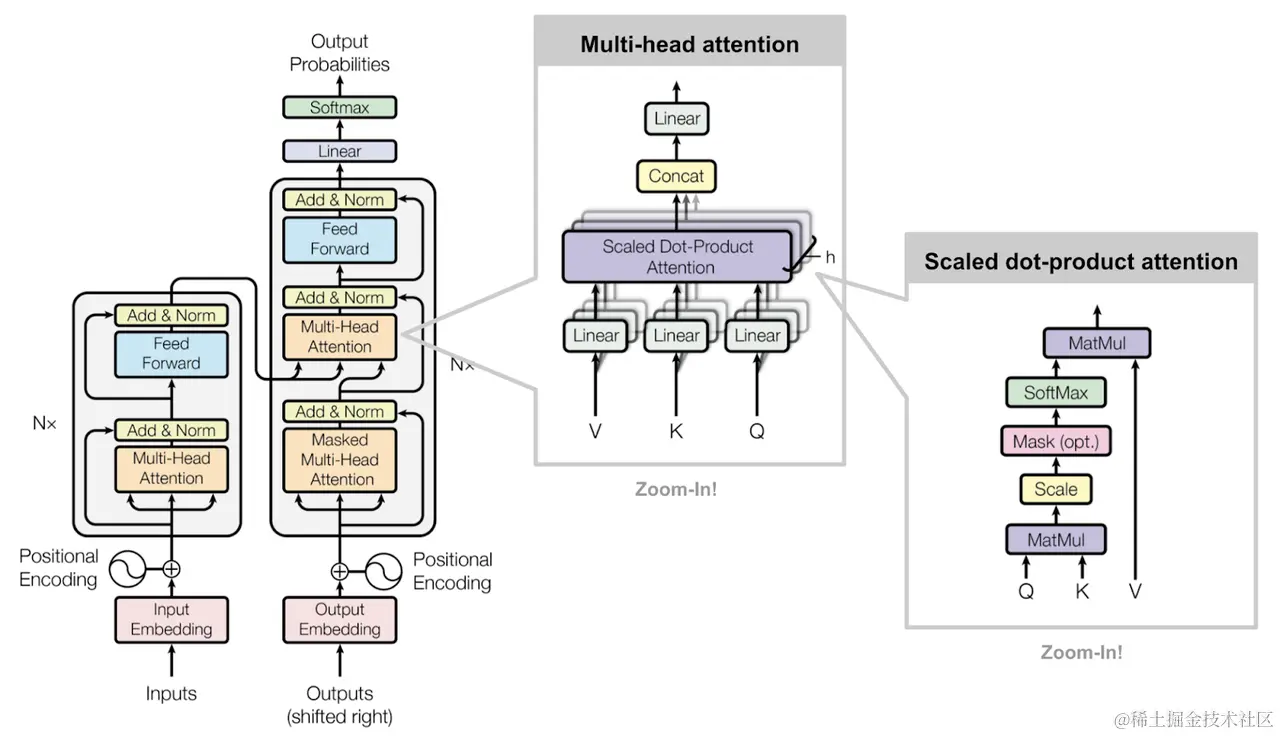
2017 年,Google 发表论文《Attention Is All You Need》,提出了 Transformer 架构。它彻底改变了 NLP,也是 GPT、Claude、DeepSeek 等模型的基础。
下面这张图是原始 Transformer 的完整结构(包含 Encoder 和 Decoder):
 图片来源:
4.1 图中这些英文标签是什么意思?
第一次看到这张图,很多人会被里面的英文缩写吓到。其实它们都是高中数学/线性代数里很基础的操作:
| 标签 | 全称/含义 | 简单解释 |
|---|---|---|
| MatMul | Matrix Multiplication | 矩阵乘法。把两个矩阵按规则相乘,是神经网络里最常用的计算。 |
| Dot-Product | 点积 | 两个向量对应位置相乘再相加,结果越大表示两个向量越"像"。Attention 里用 Q 和 K 的点积来衡量"相关性"。 |
| Scale | 缩放 | 把点积结果除以 √d_k,防止数值太大导致 Softmax 梯度消失。 |
| Mask | 掩码 | 在 Decoder 里把"未来的 Token"遮起来(变成 -∞),让模型不能偷看答案。Encoder 不需要,所以是 opt.(可选)。 |
| Softmax | 归一化指数函数 | 把任意一组分数变成"概率分布":都是正数,且加起来等于 1。 |
| Linear | 线性层 | 简单的 y = xW + b,也就是对向量做一次线性变换。 |
对应的标准 Attention 公式也要贴出来:
Attention(Q, K, V) = softmax(QK^T / √d_k) × V一句话串起来:
Q 和 K 做 MatMul(这一步本质上在计算 Dot-Product)→ Scale → Mask(可选)→ Softmax 得到权重 → 权重再和 V 做 MatMul → 最后过 Linear 层。
对 AI 应用开发者来说,不需要记住每一个方块,但要理解整体数据流:
flowchart TD
    A[输入文本] --> B[Tokenizer<br/>切分成 Token]
    B --> C[Embedding 层<br/>Token → 向量]
    C --> D[位置编码<br/>加入位置信息]
    D --> E[多层 Transformer Block]
    subgraph "一个 Transformer Block 重复 N 次"
        E --> F[Masked Self-Attention<br/>带因果掩码的自注意力]
        F --> G[Add & Norm<br/>残差连接 + 层归一化]
        G --> H[Feed Forward Network<br/>前馈神经网络]
        H --> I[Add & Norm<br/>残差连接 + 层归一化]
    end
    I --> J[线性层 + Softmax]
    J --> K[词表上的概率分布]
    K --> L[采样/取最大概率<br/>得到下一个 Token]
    L --> M[拼回已生成序列<br/>继续预测]
M --> E一句话总结:文本先变成向量,再经过多层"Attention + FFN"的处理,最后预测下一个 Token。
五、Transformer 的每一层在做什么?
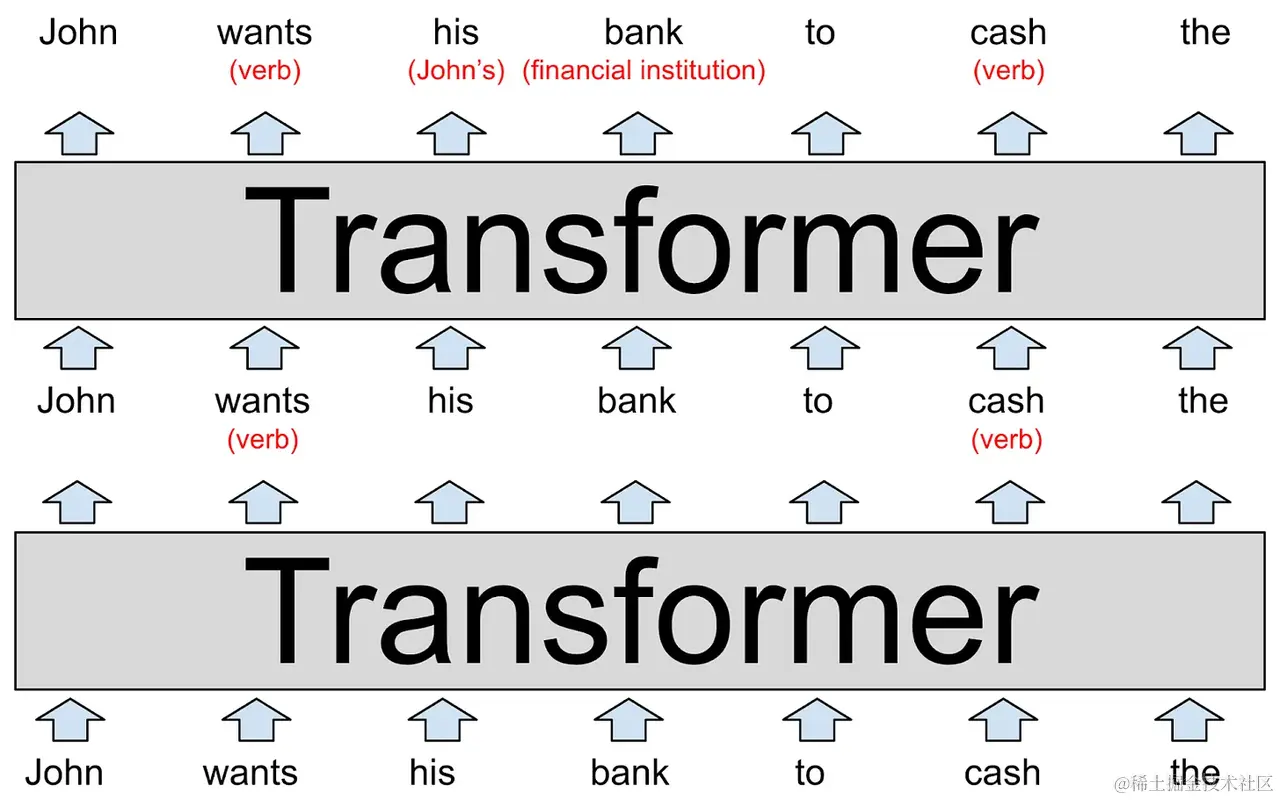
想象你读一句话:“John wants his bank to cash the “。
第一层 Transformer 可能会发现:wants 和 cash 在这里是动词;第二层会进一步澄清:his 指的是 John,bank 指的是金融机构而不是河岸。
每一层都在前一个层的基础上,给词向量"写注释”,帮助模型理解上下文。
 图片来源:
这些"注释"人类无法直接解读,但它们以数字的形式存储在词向量中,并随着层数增加逐渐丰富。最终,最后一层输出的向量包含了预测下一个 Token 所需的全部信息。
六、从 Token 到向量:输入表示
6.1 Token 与 Embedding
用户输入一句话,比如「你好世界」,模型并不会直接理解汉字。首先要经过 Tokenizer 切分成 Token:
"你好世界" → ["你", "好", "世", "界"]
或
"你好世界" → ["你好", "世界"]
不同模型的 Tokenizer 不同,这也是为什么同样的中文文本,在不同模型里 Token 数可能差很多。
每个 Token 会被映射成一个向量,叫做 Embedding:
"你" → x₁ (一个 d 维向量)
"好" → x₂
"世" → x₃
"界" → x₄
用流程图表示:
flowchart LR
    A["原始文本:<br/>你好世界"] --> B["Tokenizer<br/>分词器"]
    B --> C["Token 序列:<br/>['你', '好', '世', '界']"]
    C --> D["Embedding 层<br/>查表/投影"]
    D --> E["向量序列:<br/>x₁, x₂, x₃, x₄"]

    style A fill:#e1f5e1
    style E fill:#fff4e1
6.2 位置编码
Transformer 本身没有顺序概念(它一次看到所有 Token),所以需要加入位置信息。原始 Transformer 用正弦/余弦函数生成位置编码:
PE(pos, 2i)   = sin(pos / 10000^(2i/d_model))
PE(pos, 2i+1) = cos(pos / 10000^(2i/d_model))
直观理解:位置编码向量的左半部分变化平缓(正弦),右半部分变化较快(余弦),中间会有明显的分隔。
最终输入向量是:
x_i = Embedding(token_i) + PE(pos_i)flowchart LR
A["Token Embedding<br/>你 → x₁"] --> C["相加"]
B["位置编码<br/>pos=1 → PE₁"] --> C
C --> D["最终输入向量<br/>x₁ + PE₁"]
style D fill:#fff4e1为什么需要位置编码? 因为 Attention 机制本质上是对所有 Token 做"加权平均”,如果不告诉模型"谁在哪个位置",“我爱你"和"你爱我"对它来说就完全没有区别。
七、Self-Attention:核心计算
7.1 Q、K、V 是怎么来的?
对于每个输入向量 x_i,分别乘以三个权重矩阵,得到:
q_i = x_i × W_q
k_i = x_i × W_k
v_i = x_i × W_v- Q(Query):当前 Token 在问什么
- K(Key):每个 Token 能提供什么信息
- V(Value):每个 Token 的实际内容
W_q、W_k、W_v 是训练出来的,通过反向传播和梯度下降不断优化。
flowchart TD
    A["输入向量 x_i"] --> B["× W_q"]
    A --> C["× W_k"]
    A --> D["× W_v"]
    B --> E["q_i<br/>查询向量"]
    C --> F["k_i<br/>键向量"]
    D --> G["v_i<br/>值向量"]

    style E fill:#e1f5fe
    style F fill:#e1f5fe
    style G fill:#e1f5fe
7.2 Attention 分数计算:一步一步看
计算每个 Token 对其他 Token 的关注程度:
Attention(Q, K, V) = softmax(Q × K^T / √d_k) × V以 “q₁”(对应 Token “你”)为例,整个过程可以拆成 4 步:
flowchart TD
    A["步骤 1:算相似度<br/>q₁ × k₁, q₁ × k₂,<br/>q₁ × k₃, q₁ × k₄"] --> B["步骤 2:缩放<br/>每个分数 ÷ √d_k"]
    B --> C["步骤 3:Softmax<br/>变成概率分布<br/>和为 1"]
    C --> D["步骤 4:加权求和<br/>概率 × [v₁, v₂, v₃, v₄]<br/>得到 z₁"]

    style D fill:#fff4e1
更具体地,对于序列中的每个位置:
flowchart LR
    Q1["q₁"] --> S["点积<br/>q₁·k₁, q₁·k₂, q₁·k₃, q₁·k₄"]
    K1["k₁, k₂, k₃, k₄"] --> S
    S --> D["÷ √d_k"]
    D --> SM["Softmax"]
    SM --> W["权重:<br/>0.5, 0.3, 0.1, 0.1"]
    V1["v₁, v₂, v₃, v₄"] --> SUM["加权求和"]
    W --> SUM
    SUM --> Z["z₁ = 0.5v₁ + 0.3v₂ + 0.1v₃ + 0.1v₄"]

    style Z fill:#fff4e1
z₁ 就是 “你” 这个 Token 经过 Self-Attention 后的新表示,它融合了整个句子的信息。
注意:上面的例子假设是双向 Self-Attention(Encoder 场景),所以位置 1 能看到所有位置。如果是 GPT 这类 Decoder-only 模型,由于有因果掩码,位置 1 只能看到自己,结果会变成
z₁ = 1.0 × v₁。只有最后一个位置(比如 z₄)才能看到所有k₁, k₂, k₃, k₄。
7.3 多头 Attention
实际 Transformer 不会只算一组 Q/K/V,而是算多组(Multi-Head)。最后把多组结果拼接,再乘以 W_o:
Z = Concat(z_0, z_1, ..., z_h) × W_o多头的好处是:不同头可以关注不同类型的信息,比如一个头关注语法,一个头关注语义。
flowchart TD
    A["输入 X"] --> B1["Head 1"]
    A --> B2["Head 2"]
    A --> B3["Head ..."]
    A --> B4["Head h"]

    B1 --> C1["z₁"]
    B2 --> C2["z₂"]
    B3 --> C3["..."]
    B4 --> C4["zₕ"]

    C1 --> D["Concat<br/>拼接"]
    C2 --> D
    C3 --> D
    C4 --> D

    D --> E["× W_o<br/>线性投影"]
    E --> F["最终输出 Z"]

    style F fill:#fff4e1
7.4 一个完整演算:输入 x₁, x₂,怎么预测 x₃?
前面讲了很多公式,现在用一个具体的 Decoder-only 例子把流程走一遍。
场景:用户已经输入了 x₁, x₂(比如「你」「好」),模型要预测下一个 Token x₃(比如「世」)。
第 1 步:生成 Q、K、V
每个输入向量各自乘以三个权重矩阵:
x₁ → q₁, k₁, v₁
x₂ → q₂, k₂, v₂
第 2 步:应用因果掩码
Decoder 不能偷看未来,所以 2×2 的掩码矩阵是:
[[0, -∞],
 [0,  0]]
含义:
- 位置 1 只能看到位置 1
- 位置 2 能看到位置 1 和位置 2
flowchart LR
    subgraph "位置 1"
        A1["只能看到 x₁"]
    end
    subgraph "位置 2"
        A2["可以看到 x₁, x₂"]
    end
    A1 --> A2
第 3 步:计算 z₁
位置 1 被掩码挡住了 x₂,所以:
分数 = [q₁·k₁/√d_k,  -∞]
       ↓ Softmax
权重 = [1.0,  0.0]

z₁ = 1.0 × v₁ + 0.0 × v₂ = v₁flowchart LR
Q1["q₁"] --> S["点积<br/>q₁·k₁, -∞"]
K1["k₁, k₂"] --> S
S --> D["÷ √d_k"]
D --> SM["Softmax<br/>→ [1.0, 0.0]"]
SM --> W["权重"]
V1["v₁, v₂"] --> SUM["加权求和"]
W --> SUM
SUM --> Z["z₁ = v₁"]
style Z fill:#fff4e1第 4 步:计算 z₂
位置 2 可以看到 x₁ 和 x₂:
分数 = [q₂·k₁/√d_k,  q₂·k₂/√d_k]
       ↓ Softmax
权重 = [0.3,  0.7]   ← 假设的示例值

z₂ = 0.3 × v₁ + 0.7 × v₂flowchart LR
Q2["q₂"] --> S["点积<br/>q₂·k₁, q₂·k₂"]
K2["k₁, k₂"] --> S
S --> D["÷ √d_k"]
D --> SM["Softmax<br/>→ [0.3, 0.7]"]
SM --> W["权重"]
V2["v₁, v₂"] --> SUM["加权求和"]
W --> SUM
SUM --> Z["z₂ = 0.3v₁ + 0.7v₂"]
style Z fill:#fff4e1第 5 步:用 z₂ 预测 x₃
只有最后一个位置 z₂ 才包含"已输入全部信息”,所以:
flowchart LR
    Z2["z₂"] --> L["Linear<br/>线性层"]
    L --> SM["Softmax"]
    SM --> P["词表概率分布"]
    P --> X3["选出概率最大的 Token<br/>即 x₃"]

    style X3 fill:#fff4e1
z₁ 有必要算吗?
这个问题要分"概念上"和"工程实现上"两层来理解。
概念上:如果你只想预测 x₃,那确实只需要 z₂。z₁ 对应的是预测 x₂,不是 x₃。
工程实现上:标准 Transformer 在前向传播时会一次性把 z₁, z₂ 都算出来(因为矩阵运算适合并行)。所以 z₁ 通常还是被算了,只是它的输出被丢弃,不参与生成 x₃。
那因果掩码还有必要吗?
有必要,原因有两个:
-
架构是统一的:Transformer 不知道你这次只想要 z₂,它仍然按同样的规则处理所有位置。既然要算 z₁,就必须对 z₁ 应用掩码,防止它偷看 x₂。
-
Prompt 阶段需要并行:实际推理时,对于用户输入的整段 Prompt(比如
[x₁, x₂]),模型通常是一次性并行算出所有位置的,而不是一个一个算。这时候如果不加掩码,z₁ 就会看到后面的 x₂,破坏因果性。
KV Cache 优化:在生成后续 Token 时(比如已经生成到 [x₁, x₂, x₃],要预测 x₄),工程上会把之前算好的 K、V 缓存起来,只计算新位置。这时 z₁、z₂ 确实不会被重复计算,但因果掩码仍然保留在架构中。
八、看看真实模型长什么样:GPT-3 的维度
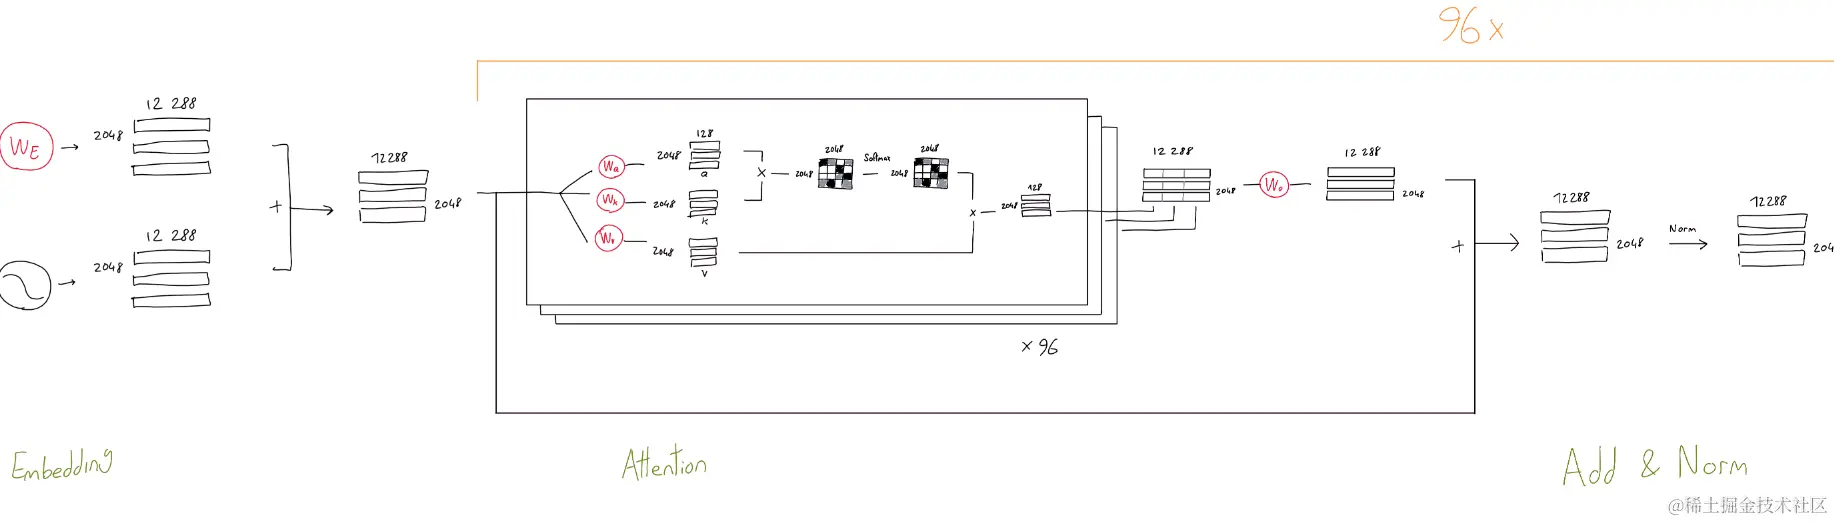
理论知识看多了,看看真实模型的尺寸会更有体感。下面是一张手绘风格的 GPT-3 结构图:
 图片来源:
从这张图可以看到几个关键数字:
- 词向量维度:12,288 —— 每个 Token 用 12,288 个数字表示
- 上下文长度:2,048 —— GPT-3 一次能处理 2,048 个 Token
- 层数:96 层 —— 同样的 Transformer Block 重复 96 次
- 参数量:约 1,750 亿 —— 这些参数就是 W_q、W_k、W_v、W_o、W₁、W₂ 等矩阵
你可以把这些高维向量看作"草稿纸",前面的层写下的注释可以被后面的层读取和修改,模型就这样逐层加深对上下文的理解。
这也解释了为什么**上下文窗口(context window)**不是无限的:每个 Token 都要和上下文里所有 Token 计算 Attention,长度越长,计算和显存开销越大。
九、Add & Norm 与 FFN
9.1 残差连接
Self-Attention 的输出会做一个残差连接:
Output = LayerNorm(Z + X)也就是把 Attention 前的输入 X 和 Attention 后的输出 Z 相加,再 Layer Normalization。
残差连接的作用:
- 缓解梯度消失,帮助深层网络训练
- 保留原始输入信息,避免 Attention 过度改变表示
flowchart TD
    A["输入 X"] --> B["Self-Attention"]
    B --> C["Z"]
    A --> D["相加<br/>X + Z"]
    C --> D
    D --> E["LayerNorm"]
    E --> F["输出"]

    style F fill:#fff4e1
9.2 Feed Forward Network
每个位置独立经过两层全连接:
FFN(x) = max(0, x × W₁ + b₁) × W₂ + b₂注意:
- 中间用 ReLU 激活
- 通常先升维(4 倍),再降维回原维度
- 每个位置独立计算,不跨位置交互
FFN 的作用是为模型引入非线性变换能力,增强表达能力。
flowchart LR
    A["输入 x"] --> B["线性层 1<br/>x × W₁ + b₁"]
    B --> C["ReLU 激活<br/>max(0, ...)"]
    C --> D["线性层 2<br/>× W₂ + b₂"]
    D --> E["输出"]

    style E fill:#fff4e1
9.3 一个完整的 Transformer Block
把上面的模块拼起来,就是一个标准的 Transformer Block:
flowchart TD
    A["输入 X"] --> B["Masked Self-Attention"]
    B --> C["X + Attention输出"]
    A --> C
    C --> D["LayerNorm"]
    D --> E["FFN"]
    E --> F["D + FFN输出"]
    D --> F
    F --> G["LayerNorm"]
    G --> H["输出"]

    style H fill:#fff4e1
这个 Block 会重复堆叠几十层(比如 GPT-3 有 96 层)。每一层都在前一层的基础上进一步提炼信息。
十、Decoder 与自回归生成
10.1 编码器 vs 解码器
原始 Transformer 有 Encoder 和 Decoder:
- Encoder:读取整个输入序列,生成上下文表示
- Decoder:根据已生成的 Token,逐个预测下一个 Token
但我们常用的 GPT、DeepSeek、Claude 等都是 Decoder-only 结构,只有解码器。
flowchart TD
    subgraph "原始 Transformer"
        A["输入序列"] --> B["Encoder"]
        B --> C["上下文表示"]
        C --> D["Decoder"]
        D --> E["输出序列"]
    end

    subgraph "GPT / Claude / DeepSeek<br/>Decoder-only"
        F["已生成 Token"] --> G["Decoder"]
        G --> H["预测下一个 Token"]
        H --> I["拼回输入"]
        I --> F
    end
10.2 因果掩码
Decoder 在训练和推理时都不能偷看未来的 Token,所以要用因果掩码(Causal Mask)。它用一个 4×4 的下三角矩阵表示:
[[0, -∞, -∞, -∞],
 [0,  0, -∞, -∞],
 [0,  0,  0, -∞],
 [0,  0,  0,  0]]
上三角为 -∞,经过 softmax 后变成 0,从而实现"不能看未来"的约束。
flowchart LR
    subgraph "位置 1"
        A1["只能看到自己<br/>你"]
    end
    subgraph "位置 2"
        A2["可以看到<br/>你、好"]
    end
    subgraph "位置 3"
        A3["可以看到<br/>你、好、世"]
    end
    subgraph "位置 4"
        A4["可以看到<br/>你、好、世、界"]
    end

    A1 --> A2 --> A3 --> A4
10.3 预测下一个 Token
Decoder 最后一个位置的隐藏状态 h_t,经过线性层和 softmax,得到词表上的概率分布:
logits = W_o × h_t + b_o
probabilities = softmax(logits)
词表通常有几万维,每一维代表一个 Token 的概率。选择概率最高的 Token 作为输出。
flowchart LR
    A["最后一个隐藏状态 h_t"] --> B["线性层<br/>W_o × h_t + b_o"]
    B --> C["Logits<br/>词表大小维度的分数"]
    C --> D["Softmax"]
    D --> E["概率分布"]
    E --> F["取 argmax<br/>或采样"]
    F --> G["下一个 Token"]

    style G fill:#fff4e1
10.4 为什么预测的是 t+1?
训练时,输入序列的每个位置 i 都对应一个标签:下一个位置 i+1 的 Token。
输入:[你, 好, 世, 界]
标签:[好, 世, 界, EOS]
所以位置 i 的隐状态 h_i 被训练来预测位置 i+1。
推理时,模型每次用已生成的所有 Token 预测下一个 Token,然后把它拼回输入,继续预测。
10.5 自回归生成流程
自回归的核心就是"一步一步来":
flowchart LR
    A["输入:你"] --> B["预测:好"]
    B --> C["输入:你好"]
    C --> D["预测:世"]
    D --> E["输入:你好世"]
    E --> F["预测:界"]
    F --> G["输入:你好世界"]
    G --> H["预测:EOS"]
    H --> I["结束"]

    style I fill:#fff4e1
10.6 训练 vs 推理:有什么不一样?
flowchart TD
    subgraph 训练阶段
        A["输入:你好世界"] --> B["一次前向传播"]
        B --> C["同时计算所有位置"]
        C --> D["位置1 预测 好<br/>位置2 预测 世<br/>位置3 预测 界<br/>位置4 预测 EOS"]
    end

    subgraph 推理阶段
        E["输入:你"] --> F["预测 好"]
        F --> G["输入:你好"]
        G --> H["预测 世"]
        H --> I["..."]
end关键区别:训练时和推理时都会用因果掩码,区别在于——训练时可以一次性输入整句话,并行计算所有位置(同时得到所有位置的预测结果);推理时只能一个一个地生成,每次把已生成的 Token 拼回去再预测下一个。
10.7 生成什么时候结束?
通常有两个停止条件:
- 生成了结束符 EOS(End of Sequence)
- 达到了预设的最大生成长度
实际工程中还会加上停止字符串等兜底策略。
flowchart TD
    A["模型预测下一个 Token"] --> B{"是 EOS 吗?"}
    B -->|是| C["结束生成"]
    B -->|否| D{"超过最大长度?"}
    D -->|是| C
    D -->|否| E["拼回输入<br/>继续预测"]
    E --> A
十一、模型是怎么训练出来的?
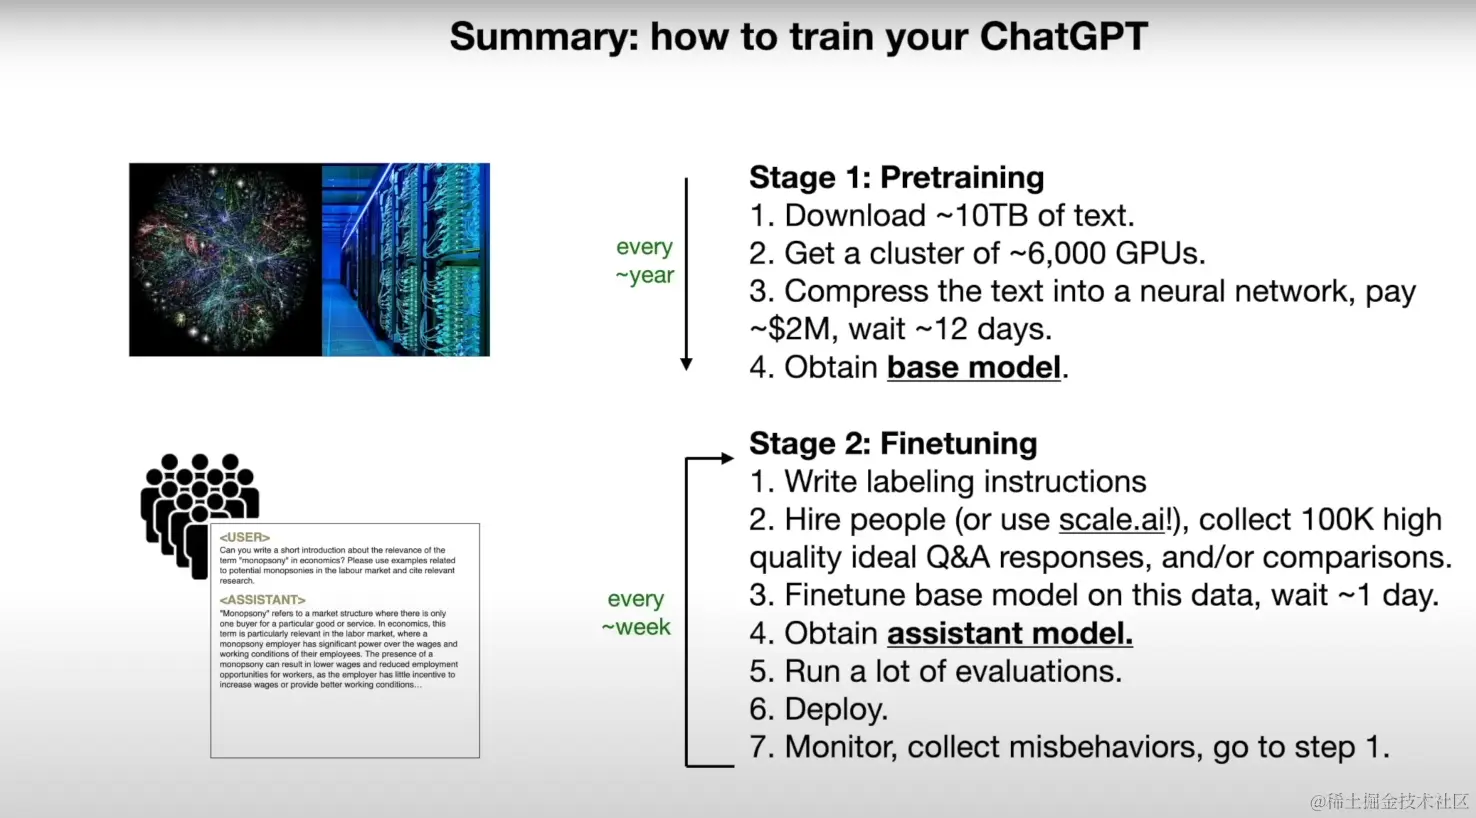
理解 Transformer 的结构后,再来看模型是怎么"学会"的。整个过程可以分成两个阶段:
- 预训练(Pre-training):让模型学会语言的基本规律
- 微调(Fine-tuning):让模型学会遵循指令、生成有用回答
 图片来源:
11.1 预训练:词语接龙
预训练阶段,模型会阅读海量文本(网页、书籍、维基百科等),学习目标很简单:给定前 N 个 Token,预测第 N+1 个 Token。
例如:
今天是个好天气,我准备去____模型会预测"公园"、“超市”、“图书馆"等词的概率。预测错了就调整参数,预测对了也微调,让概率分布更接近真实世界。
GPT-3 的预训练数据构成如下:
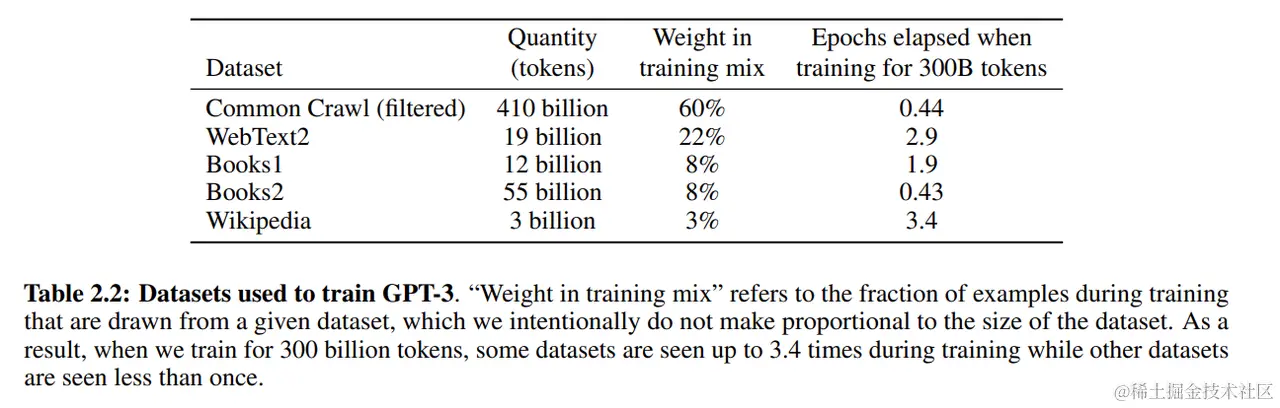 图片来源:
可以看到:
- Common Crawl 占大头,但经过了过滤
- WebText2 是高质量网页文本
- Books1/Books2 是书籍数据
- Wikipedia 虽然量少但质量高
Common Crawl 的数据来源非常广泛:
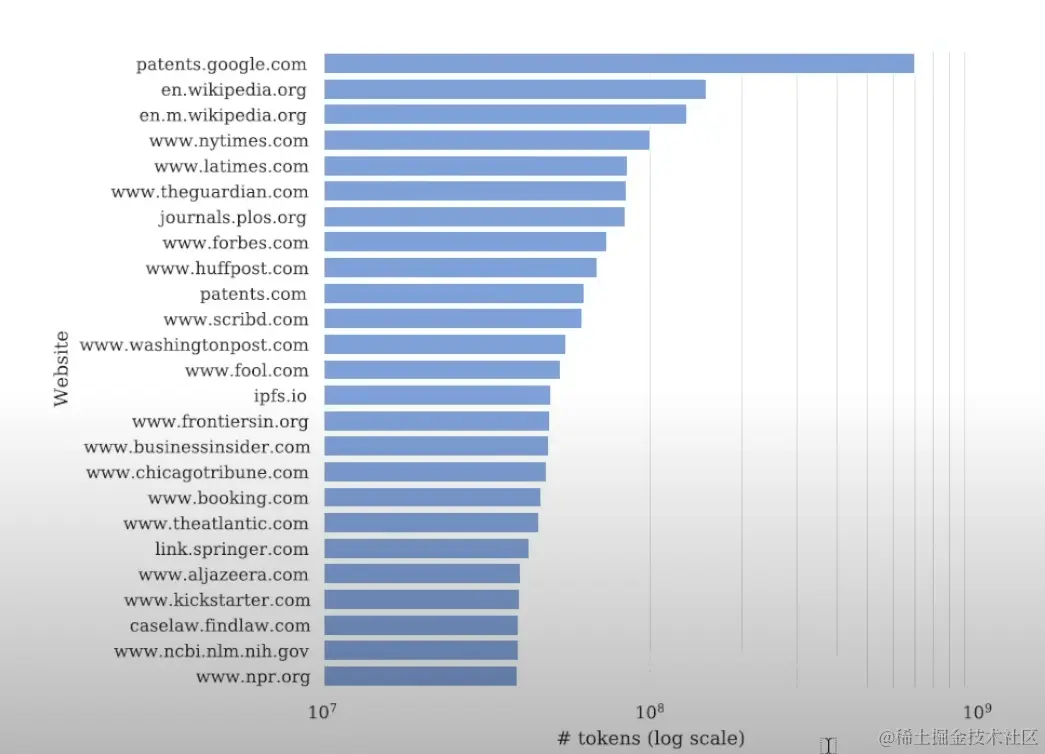 图片来源:
预训练完成后得到的是基座模型(Base Model)。它很擅长"续写”,但不一定擅长对话或遵循指令。比如你让它"写一首关于月亮的诗",它可能只会开始写关于月亮的百科介绍。
11.2 微调:让模型变成"助手"
微调阶段,研究人员会准备大量高质量的"指令-回答"数据对,比如 Alpaca 数据集:
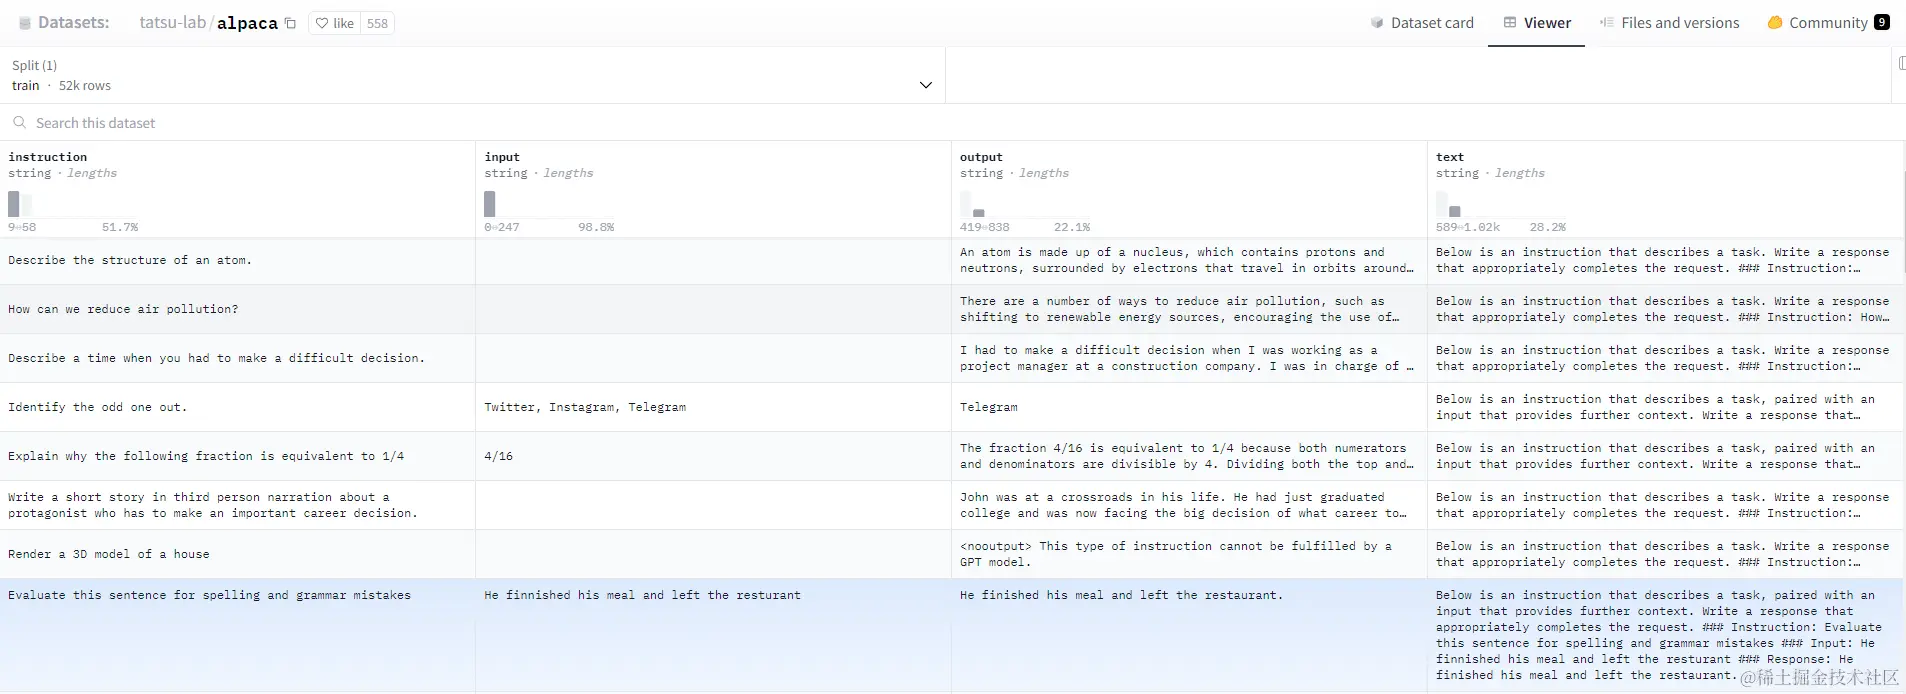 图片来源:
每一行包含:
- Instruction:任务指令
- Input:可选的输入上下文
- Output:期望的回答
- Text:拼接后的完整训练样本
通过在这些数据上继续训练,模型学会了理解指令、按格式输出、拒绝有害请求等能力,最终变成我们日常使用的助手模型(Assistant Model)。
11.3 RLHF:人类反馈强化学习
更进一步的训练还会用到 RLHF(Reinforcement Learning from Human Feedback):
- 让模型对同一个问题生成多个回答
- 人类标注员比较哪个回答更好
- 用这些比较数据训练一个"奖励模型"
- 用奖励模型指导基座模型生成更人类喜欢的回答
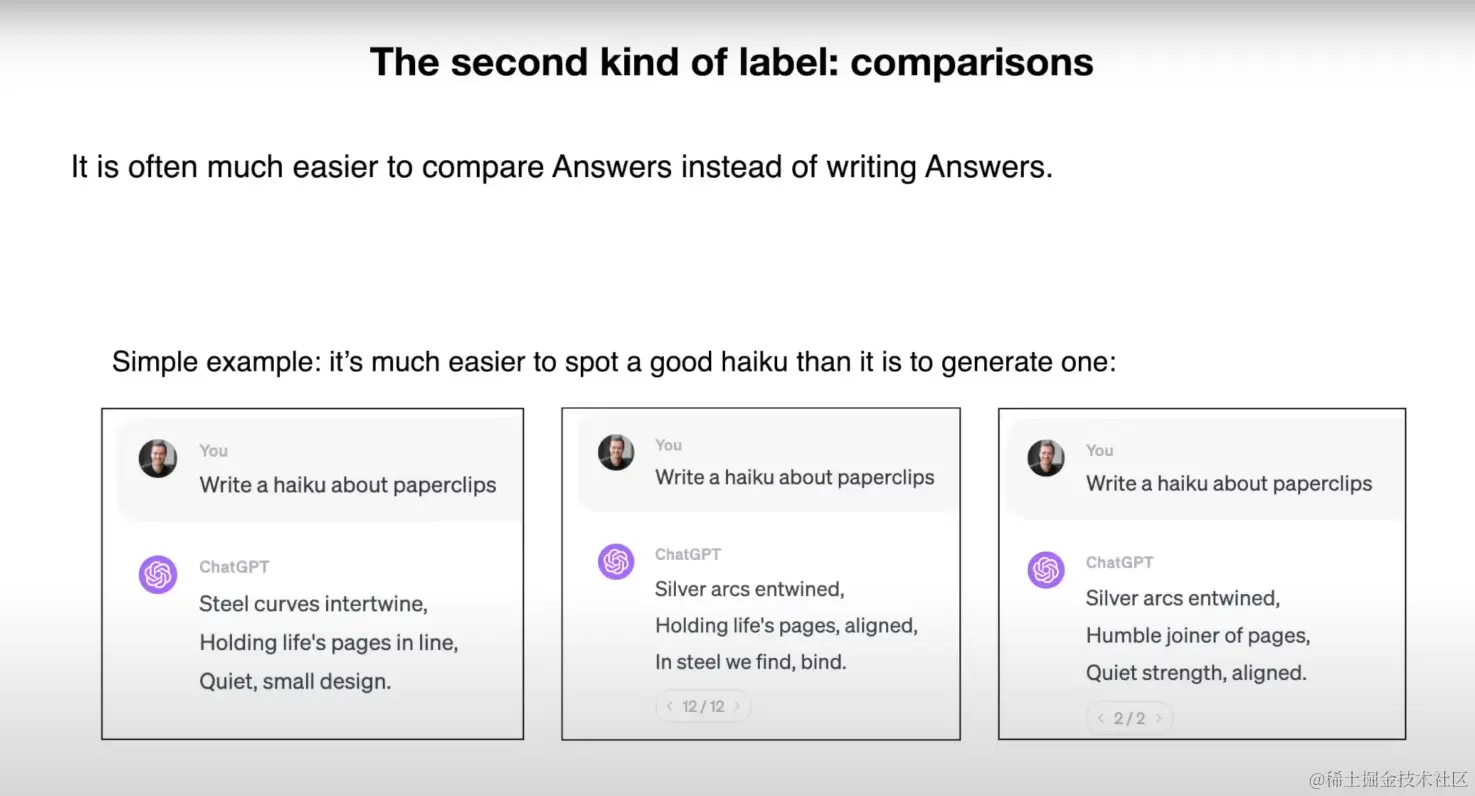 图片来源:
为什么用"比较"而不是"写答案"?因为对人类来说,判断哪个回答更好往往比自己写回答容易得多。
十二、上下文窗口的限制
前文提到,Transformer 的上下文窗口不是无限的。GPT-3 只有 2,048 个 Token,GPT-4 后来扩展到 128K,但即便如此,长上下文下的信息检索也会下降。
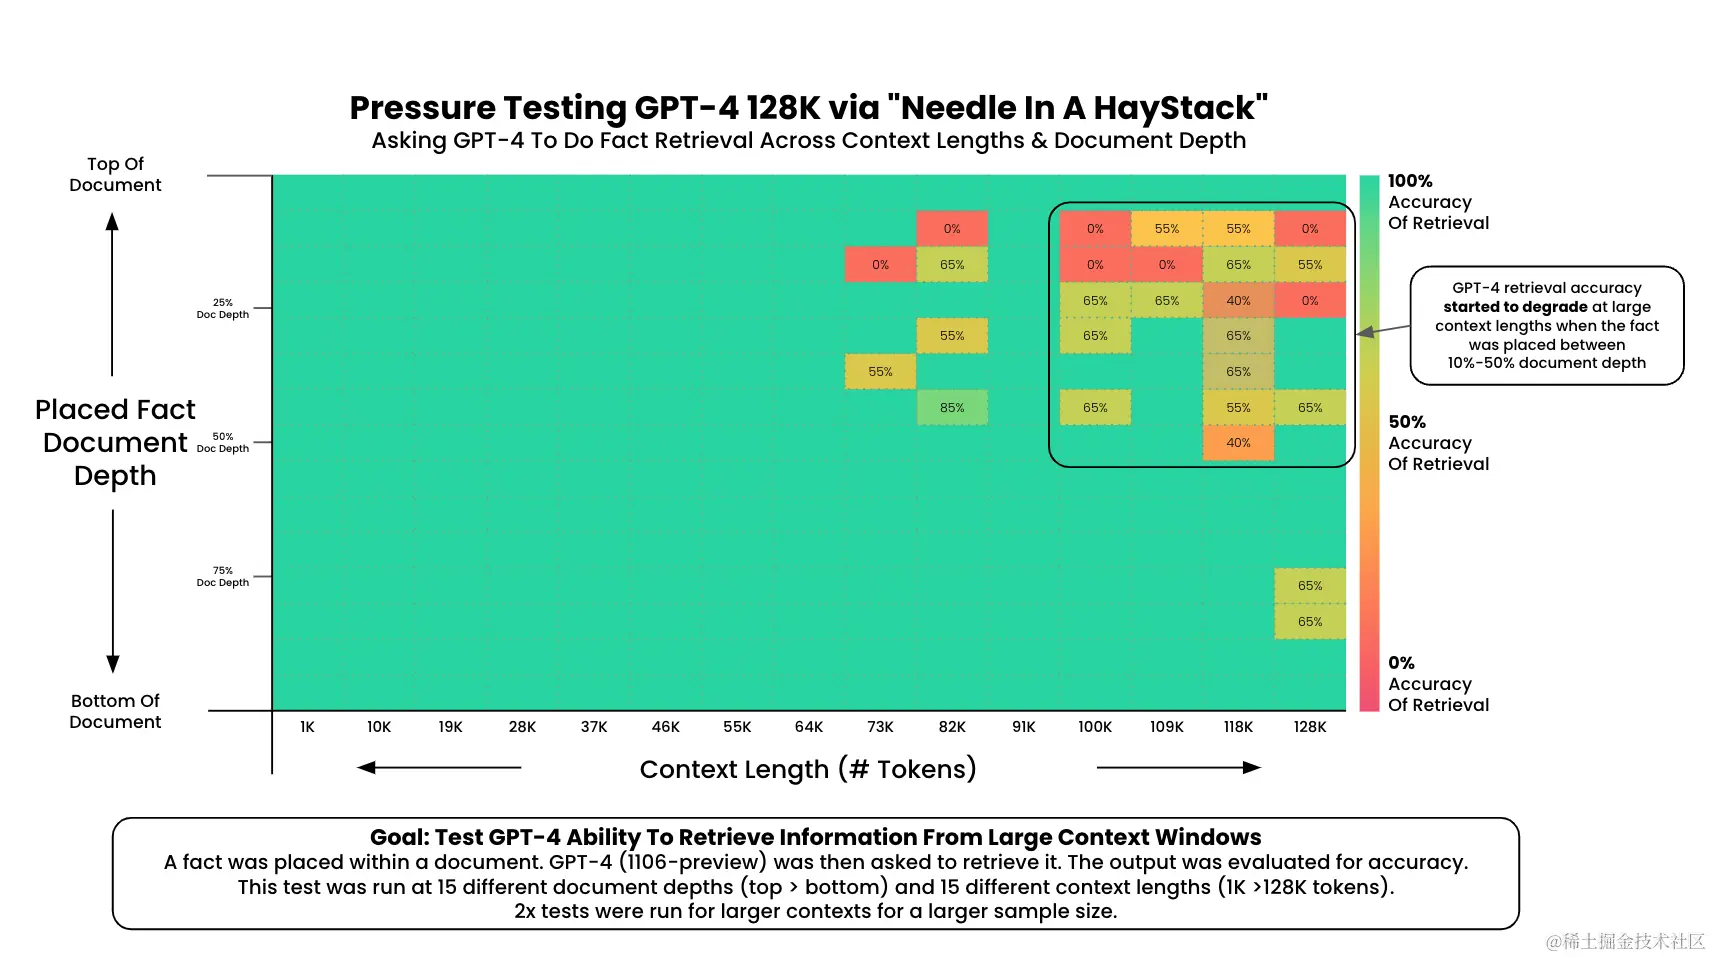
下面这张图是著名的"大海捞针"测试(Needle In A Haystack):把一条关键信息藏在长文档的不同位置,然后让模型回答相关问题。
 图片来源:
绿色表示模型能准确找到信息,红色/黄色表示失败。可以看到:
- 当文档较短时,模型几乎全能找到
- 当文档很长、且关键信息位于中间位置时,准确率明显下降
- 这就是常说的 “Lost in the Middle” 问题
对 AI 工程师的启示:
- 不要把整本书直接塞进 Prompt
- 做 RAG 时,召回的 chunk 要尽量精准
- 关键信息尽量放在上下文的开头或结尾
十三、这些知识在工程中有什么用?
13.1 理解 Token 消耗
模型的输入和输出都按 Token 计费。理解 Tokenizer 后,你会知道:
- 为什么中文比英文更"贵"
- 为什么同样的 Prompt 在不同模型上价格不同
- 为什么长文本容易超出上下文窗口
13.2 设计更好的 RAG
Attention 机制让模型能关注输入中的相关信息。做 RAG 时:
- 召回的 chunk 要尽量相关
- 上下文不能太长,否则注意力会稀释
- 关键信息要放在 Prompt 的重要位置
13.3 理解 LLM 的局限性
- LLM 是自回归生成,每次只预测下一个 Token,所以会出现"说胡话"
- 没有真正的推理,只是概率模式匹配
- 上下文窗口有限,不能无限记忆
这些认知会直接影响你的产品设计方案。
十四、延伸:DeepSeek 的 MLA
传统 Transformer 的 Attention 需要保存每个 Token 的 K 和 V,显存开销大。
DeepSeek 的 MLA(Multi-head Latent Attention) 做了压缩:不再直接存储完整的 K/V,而是存储一个低维的潜在向量,推理时动态解压。
这样显著降低了显存占用,让长上下文推理更便宜。
对于应用开发者来说,这意味着:
- 长上下文能力的成本在下降
- 未来可以设计更复杂的 Agent 工作流
- 但仍要关注 Token 成本
flowchart LR
    subgraph "传统 Attention"
        A1["每个 Token 存储完整 K, V"] --> B1["显存占用大"]
    end

    subgraph "MLA"
        A2["每个 Token 存储低维潜在向量"] --> B2["推理时动态解压为 K, V"]
        B2 --> C2["显存占用小"]
    end
十五、总结
Transformer 不需要你推导每个公式,但核心机制要知道:
- 输入:Token → Embedding + 位置编码
- Attention:Q/K/V 计算,softmax 得到关注权重
- 残差与 FFN:帮助深层网络训练和非线性表达
- Decoder:因果掩码 + 自回归生成
- 输出:线性层 + softmax 预测下一个 Token
- 训练:预训练学语言规律,微调学指令遵循
作为 AI 工程师,理解这些不是为了造模型,而是为了更好地使用模型、设计产品、控制成本。
flowchart TD
    A["输入文本"] --> B["Token + Embedding"]
    B --> C["位置编码"]
    C --> D["Multi-Head Self-Attention"]
    D --> E["Add & Norm"]
    E --> F["FFN"]
    F --> G["Add & Norm"]
    G --> H["重复 N 层"]
    H --> I["Linear + Softmax"]
    I --> J["预测下一个 Token"]

    style J fill:#fff4e1
你对 Transformer 的哪个部分最困惑?欢迎在评论区讨论。
参考文章:

18 年后端架构,现在独立做 AI 产品。这里记录 AI 视频、AI Agent 与工程实践。