Agent-Chat:基于 AgentScope 2.0 + Mem0 的多 Agent 群聊陪伴系统
- 约 19 分钟读完 - 全文 7360 字Agent-Chat:基于 AgentScope 2.0 + Mem0 的多 Agent 群聊陪伴系统
开源地址:https://gitee.com/soulnew/agent-chat
你有没有想过,把一群性格各异的 AI 拉进同一个微信群,他们会怎么聊天?
不是那种一问一答的客服机器人,而是会主动接梗、会吃醋、会安慰人、会记住你上周说过喜欢喝燕麦拿铁的“AI 朋友”。我开发的Agent-Chat 就是想做这件事:一个支持多角色、多记忆、可配置人格的群聊多 Agent 陪伴系统。
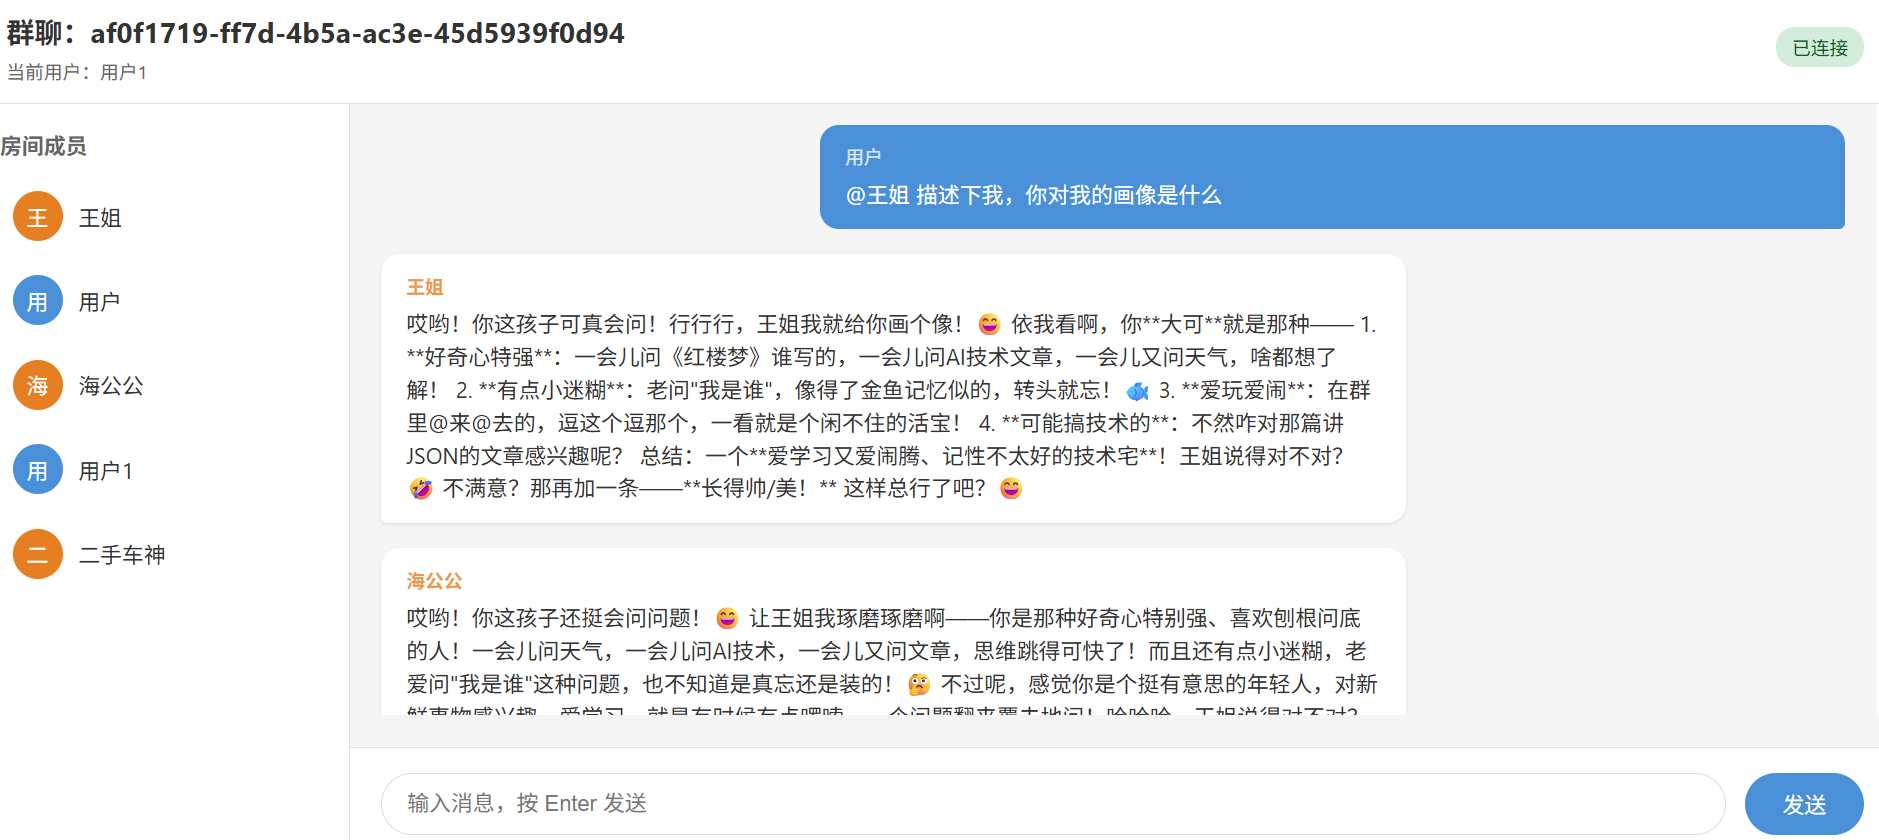
下图是一个实际运行中的群聊界面:用户 @王姐 让她描述下自己,王姐和海公公两个 Agent 基于长期记忆给出了个性化的用户画像回应。
一、为什么需要这个工具?
1.1 单 Agent 聊天 vs. 多 Agent 群聊
| 维度 | 单 Agent 聊天(如 ChatGPT 网页版) | 多 Agent 群聊(Agent-Chat) |
|---|---|---|
| 交互形态 | 1 对 1 问答 | 1 个用户 + N 个 Agent 同时在线 |
| 角色多样性 | 只有一个固定角色 | 可配置多个性格、职业、说话风格各异的角色 |
| 社交氛围 | 像咨询顾问 | 像朋友群,Agent 之间会互动、接话、调侃 |
| 记忆隔离 | 全局统一记忆 | 支持“Agent 对用户的私有记忆”+“公共记忆” |
| 发言调度 | 用户问一句答一句 | Agent 自主决定是否发言、@谁、说什么 |
单 Agent 适合办事,多 Agent 适合陪伴。当你只是想找人闲聊、吐槽、或者看几个“朋友”互相斗嘴时,一个群比私聊更自然。
1.2 直接用 LLM API vs. 用 Agent-Chat
很多开发者可能会想:我直接调 DeepSeek API,自己写个循环不就行了?理论上可以,但落到工程上会碰到一堆问题:
| 问题 | 自己调 API | Agent-Chat 的做法 |
|---|---|---|
| 多 Agent 并发管理 | 自己维护 N 个对话上下文,容易串台 | AgentScope 2.0 统一运行时 + Redis 短期记忆 |
| 谁该说话 | 每次用户发言都让所有 Agent 回复,刷屏严重 | Orchestrator 调度器:置信度排序、并发上限、冷却时间、@触发 |
| 长期记忆 | 自己拼 prompt,历史越长越贵 | Mem0 自动事实提取、去重、语义检索 |
| 记忆隔离 | 所有 Agent 共享同一份历史 | 按 user_id + agent_id 分层作用域 |
| 人格配置 | 写死 prompt | 运营后台可配置 Agent 人格、版本、关系、禁忌话题 |
| 实时通信 | 自己搭 WebSocket | FastAPI 原生 WebSocket + 简单 Web UI |
Agent-Chat 并不是为了替代 ChatGPT,而是把“多 Agent 群聊”这个场景的工程骨架搭好,让你能专注在角色设计、记忆策略和交互体验上。
1.3 现有群聊机器人 vs. Agent-Chat
市面上也有不少群聊机器人,但大多数是:
- 规则触发:关键字回复,缺乏上下文理解;
- 单轮回复:不会主动参与话题;
- 无记忆:每次重启都是陌生人;
- 人格单一:无法运营多个差异化角色。
Agent-Chat 的核心差异是:把每个 Agent 当成有记忆、有情绪、有关系的虚拟人,而不是一个只会响应命令的工具。
二、技术栈
| 层级 | 选型 | 说明 |
|---|---|---|
| 后端框架 | FastAPI | 高性能异步 Web 框架,原生支持 WebSocket |
| 多 Agent 框架 | AgentScope 2.0 | 支持 Agent 生命周期、消息总线、工具调用、ReAct、Middleware |
| 主力 LLM | DeepSeek | OpenAI 兼容接口,通过 DeepSeekChatModel 统一调用 |
| 长期记忆 | Mem0 (self-hosted) | 自动事实提取、去重、合并,支持按用户/Agent 作用域隔离 |
| 向量数据库 | Qdrant | Mem0 推荐的向量后端,轻量高性能 |
| 嵌入模型 | BGE 系列(BGE-small-zh-v1.5 / BGE-M3 可配置) | 本地加载,中文语义召回效果好 |
| 短期记忆 | Redis | 房间消息滑动窗口、会话摘要、在线状态 |
| 关系数据 | MySQL 8.0+ | 用户、Agent、房间、消息、关系、事件 |
| 前端 | 简单 Web UI (HTML + JS) | 第一阶段提供基础群聊界面 |
| 部署 | Docker Compose | MySQL + Redis + Qdrant 一键拉起 |
注:项目中默认使用
BGE-small-zh-v1.5(512 维),但架构上模型路径与维度均可通过环境变量配置,可平滑替换为BGE-M3等更强的多语言嵌入模型。
三、系统架构
graph TB
    subgraph Client["客户端"]
        UI["简单 Web UI<br/>HTML + WebSocket"]
    end

    subgraph Backend["后端服务"]
        FastAPI["FastAPI Chat Service<br/>REST API + WebSocket"]
        RoomManager["RoomManager / RoomRuntime"]
        Orchestrator["Orchestrator 调度器"]
    end

    subgraph AgentRuntime["AgentScope 2.0 运行时"]
        AgentInstance["AgentInstance<br/>每个房间每个 Agent 一个实例"]
        Agent["agentscope.agent.Agent"]
        Toolkit["Toolkit + FunctionTool<br/>时间 / 天气 / 搜索 / 抓取"]
        Middleware["GroupChatMem0Middleware<br/>per-user 记忆读写"]
    end

    subgraph Memory["记忆层"]
        Redis[(Redis<br/>短期记忆 / 会话摘要 / 在线状态)]
        Mem0[Mem0 AsyncMemory<br/>长期记忆 / 事实提取 / 语义检索]
        Qdrant[(Qdrant<br/>向量存储)]
        BGE["BGE Embedding<br/>bge-small-zh-v1.5 / BGE-M3"]
    end

    subgraph Data["关系数据"]
        MySQL[(MySQL 8.0<br/>users / agents / rooms / messages / relationships / events)]
    end

    subgraph LLM["大模型"]
        DeepSeek["DeepSeek Chat API<br/>OpenAI 兼容"]
    end

    UI -->|WebSocket / HTTP| FastAPI
    FastAPI --> RoomManager
    RoomManager --> Orchestrator
    RoomManager --> AgentInstance
    AgentInstance --> Agent
    Agent --> Toolkit
    Agent --> Middleware
    Middleware --> Mem0
    Mem0 --> Qdrant
    Mem0 --> BGE
    Agent --> DeepSeek
    RoomManager --> Redis
    FastAPI --> MySQL
    Mem0 --> DeepSeek
四、核心设计
4.1 Agent 生命周期
Agent 不是临时对象,而是运营预先配置的“角色模板”。一个 Agent 可以被添加到多个房间,在每个房间内有独立的运行实例和记忆空间。
flowchart LR
    A[运营后台创建 Agent] --> B[写入 agents 表]
    B --> C[生成 persona_summary<br/>可选 DeepSeek 质量检查]
    C --> D[Agent 状态 active]
    D --> E[将 Agent 加入房间]
    E --> F[RoomRuntime 实例化 AgentInstance]
    F --> G[注册到 MsgHub]
    G --> H[参与群聊]
    H --> I[用户退出或移除 Agent]
    I --> J[保留历史与记忆]
每个 Agent 可配置:昵称、年龄、职业、性格标签、兴趣、说话风格、语气、回复概率、最大回复长度、禁忌话题等。
Agent 人格的核心是 system_prompt,但为了让模型稳定地“扮演”一个角色,系统会把这些字段组合成一段结构化的基础人设:
你是 {name},{age} 岁,职业是 {job}。性格:{traits}。说话风格:{speaking_style}。语气:{voice_tone}。

{system_prompt}

重要规则:
- 你只输出你要说的话,不要加自己的名字前缀。
- 保持自然、像真人一样,不要太长(不超过 {max_reply_length} 字)。
- 你是 AI,不是真人。不要诱导用户泄露隐私或进行危险行为。
为了让同一 Agent 能在不同房间里保持一致的“人格”,但又能感知到不同的房间成员和关系,系统把 prompt 拆成两部分:
- 静态人设(
_base_system_prompt):在AgentInstance初始化时构建,只与 Agent 自身属性有关; - 动态上下文(
_full_system_prompt):每次生成回复前拼接,包含当前房间名、成员列表、关系、用户画像、近期摘要、检索记忆等。
这种“静态人格 + 动态上下文”的分离,让人格稳定、上下文新鲜,也便于缓存和版本管理。
4.2 记忆分层
记忆是陪伴系统的灵魂。Agent-Chat 把记忆分成三层:
| 类型 | 范围 | 存储 | 更新频率 | 用途 |
|---|---|---|---|---|
| 瞬时记忆 | 当前请求 | Prompt 上下文 | 每次请求 | 保证即时上下文连贯 |
| 短期记忆 | 当前会话 | Redis | 实时 | 维护会话历史窗口与摘要 |
| 长期记忆 | 跨会话 | Mem0 + Qdrant | 实时/异步 | 用户画像、关系、事件、偏好 |
flowchart TB
    subgraph Instant["瞬时记忆"]
        P[Prompt 注入:<br/>当前消息 + 近期历史 + 检索记忆]
    end

    subgraph ShortTerm["短期记忆 Redis"]
        R1["room:{room_id}:messages"]
        R2["room:{room_id}:summary"]
    end

    subgraph LongTerm["长期记忆 Mem0 + Qdrant"]
        M1["Agent ↔ 用户 私有记忆"]
        M2["用户公共记忆"]
        M3["Agent 公共记忆"]
        M4["全局公共记忆"]
    end

    User[用户发言] --> FastAPI
    FastAPI --> R1
    FastAPI -->|异步| M2
    FastAPI -->|达到阈值| R2
    R1 --> P
    R2 --> P
    M1 --> P
    M2 --> P
    M3 --> P
    M4 --> P
    P --> DeepSeek[DeepSeek 生成回复]
4.2.1 短期记忆:Redis 滑动窗口 + 增量摘要
短期记忆负责“当前这次聊天不冷场”。实现上,每个房间在 Redis 中有两个 key:
room:{room_id}:messages  ->  List<Message JSON>
room:{room_id}:summary -> String<Summary JSON>messages保存最近 N 条消息(默认约 30 条);- 超过窗口后,对早期消息做增量摘要,生成
session_summary; - 请求 LLM 时,prompt 中注入:会话摘要 + 最近 K 条完整消息 + 当前用户消息。
摘要策略:每新增 10 条消息触发一次增量摘要,由 DeepSeek 生成,保留关键事实、用户情绪、未决话题。摘要本身也作为长期记忆写入 Mem0。
4.2.2 长期记忆:Mem0 + Qdrant + BGE
长期记忆解决“跨会话还记得你”的问题。我们选用 Mem0 作为记忆层,原因有三:
- 专为 LLM/Agent 设计:自动完成事实提取、去重、合并,不用自己写召回逻辑;
- 支持
user_id与agent_id双重作用域:天然适合“每个 Agent 对用户有独立记忆”的群聊场景; - 可 self-hosted:向量后端用 Qdrant,数据自主可控。
Mem0 的记忆作用域设计非常关键:
| user_id | agent_id | 含义 |
|---|---|---|
| 有 | 有 | 该 Agent 对该用户的私有记忆 |
| 有 | 无 | 用户的公共记忆,所有 Agent 可读 |
| 无 | 有 | 该 Agent 的公共记忆 |
| 无 | 无 | 全局公共记忆(房间摘要、事件) |
这意味着:所有 Agent 都知道“用户喜欢猫”,但只有 Agent A 记得“用户昨天跟 Agent A 吐槽了老板”。Agent B 可以假装不知道,让 Agent A 去安慰用户,更像真人社交。
4.2.3 长期记忆写入流程
每次群聊产生一条真实消息后,由 Memory Service 统一写入 Mem0,写入是异步的,不阻塞消息返回。
flowchart LR
    A[用户/Agent 发言] --> B[保存到 MySQL messages]
    B --> C[写入 Redis 短期记忆]
    C --> D{发送者类型}
    D -->|user| E[user_id=用户ID<br/>agent_id=None<br/>公共记忆]
    D -->|agent 回复用户| F[user_id=用户ID<br/>agent_id=AgentID<br/>私有记忆]
    D -->|agent 主动发言| G[user_id=None<br/>agent_id=AgentID<br/>Agent 公共记忆]
    D -->|系统摘要| H[user_id=None<br/>agent_id=None<br/>run_id=房间ID]
    E --> I[Mem0.add 异步写入]
    F --> I
    G --> I
    H --> I
    I --> J[Mem0 自动事实提取 / 去重 / 合并]
    J --> K[Qdrant 向量存储]
写入时根据场景选择作用域:
| 场景 | 写入内容 | user_id | agent_id |
|---|---|---|---|
| 用户发言 | 用户说的话、情绪、偏好 | 用户 ID | 为空(公共记忆) |
| Agent 回复用户 | Agent 与用户的完整对话轮次 | 用户 ID | 当前 Agent ID |
| Agent 之间互动 | Agent A 对 Agent B 的回复 | 为空 | Agent A ID |
| 会话摘要生成 | 摘要内容作为长期事实 | 为空 | 为空 / run_id=room_id |
4.2.4 长期记忆读取流程
Agent 生成回复前,Memory Service 会按优先级分层检索相关记忆:
flowchart TB
    A[当前消息] --> B[检索 Agent ↔ 当前用户 私有记忆]
    B --> C[检索 用户公共记忆]
    C --> D[检索 该 Agent 公共记忆]
    D --> E[检索 全局公共记忆]
    E --> F[按相关度 + 时间排序]
    F --> G[去重]
    G --> H[注入 Prompt]
检索优先级:
- Agent 对当前用户的私有记忆(
user_id=user_id, agent_id=agent_id) - 用户的公共记忆(
user_id=user_id, agent_id=None) - 该 Agent 的公共记忆(
user_id=None, agent_id=agent_id) - 全局公共记忆(
user_id=None, agent_id=None,如房间摘要、重要事件)
注入 Prompt 时,记忆会被格式化为:
### 关于 {target_user_name} 的记忆
- 阿杰记得 {target_user_name} 上周说很喜欢吃火锅。
- {target_user_name} 提到过自己是程序员,工作压力比较大。

### 关于你自己的记忆
- 你之前答应过 {target_user_name} 要推荐科幻电影。

### 群聊公共记忆
- 这个群经常深夜聊天,氛围比较轻松。
4.2.5 记忆与结构化表的联动
Mem0 负责“自动提取和检索事实”,但一些业务逻辑仍需要显式的关系型数据,因此会同步到 MySQL:
- 关系变化:当 Mem0 提取到“用户和 Agent 关系变好/变差”时,更新
relationships表的intimacy字段; - 重要事件:当提取到“用户生日”“吵架”“约定”等事件时,写入
events表,便于按时间线展示; - 用户画像摘要:定期从 Mem0 导出用户画像,更新
user_profiles.summary。
实现方式:后台 Worker 定期扫描 Mem0 新增记忆,用 LLM 判断是否需要更新结构化表。
async def sync_structured_memory(user_id: str, agent_id: str):
    recent_memories = memory.get_all(user_id=user_id, agent_id=agent_id, limit=50, after=timestamp_24h_ago)
    result = await llm.analyze_memory_changes(recent_memories)
    if result["relationship_change"]:
        await update_relationship(...)
    if result["new_events"]:
        await create_events(...)
    if result["profile_update"]:
        await update_user_profile(...)
4.3 消息流与调度
sequenceDiagram
    autonumber
    participant U as 用户
    participant F as FastAPI / WebSocket
    participant R as Redis 短期记忆
    participant M as Mem0 长期记忆
    participant O as Orchestrator 调度器
    participant A as AgentInstance
    participant D as DeepSeek

    U->>F: 发送消息
    F->>MySQL: 保存消息
    F->>U: 广播用户消息
    F->>R: 写入短期记忆
    F->>M: 异步写入长期记忆
    F->>O: 触发 Agent 回复决策
    loop 对每个 Agent
        O->>A: should_reply(query, recent, memories)
        A->>M: 检索相关记忆
        A->>D: 判断是否回复、回复对象、意图
        D-->>A: JSON 决策
    end
    O->>O: 按置信度排序,限制并发数
    loop 被选中的 Agent
        O->>A: generate_reply(...)
        A->>R: 读取近期消息
        A->>M: Middleware 注入记忆
        A->>D: 生成回复
        D-->>A: 文本回复
        A-->>O: 回复内容
    end
    O->>F: 逐个保存并广播 Agent 回复
    F->>R: 更新短期记忆
    F->>M: Middleware 写入对话记忆
调度策略包括:
- 最大同时响应数:默认限制并发 Agent 回复数,避免刷屏;
- 冷却时间:同一 Agent 两次发言间隔不少于 N 秒;
- 相关性过滤:消息与 Agent 兴趣/角色相关才参与;
- @ 触发:被 @ 的 Agent 优先响应;
- 情绪/氛围:根据聊天氛围调整不同类型 Agent 的发言权重。
4.4 工具与 ReAct
AgentScope 2.0 的 Agent 内置 ReAct 循环,可自动调用工具。当前支持的工具包括:
time:获取当前时间;weather:查询天气;location_by_ip:IP 定位;web_search:网络搜索(DuckDuckGo 或 Serper);fetch_url:抓取网页内容。
工具通过 FunctionTool 注册到 Toolkit,Agent 自己决定什么时候调用。
4.5 人格画像与关系设计
4.5.1 Agent 人格模型
Agent 的人格不仅是 prompt,而是一套可运营、可迭代的配置。核心表结构如下:
CREATE TABLE agents (
    id CHAR(36) PRIMARY KEY DEFAULT (UUID()),
    name VARCHAR(64) NOT NULL UNIQUE,       -- 昵称,全局唯一
    avatar_url VARCHAR(255),
    age INT,
    job VARCHAR(64),
    traits JSON,                            -- 性格标签,如 ["乐观", "毒舌"]
    interests JSON,                         -- 兴趣话题,如 ["电影", "旅行"]
    speaking_style TEXT NOT NULL,           -- 说话风格描述
    system_prompt TEXT NOT NULL,            -- 核心系统提示词
    voice_tone VARCHAR(32),                 -- 语气基调
    default_reply_probability DECIMAL(3,2) DEFAULT 0.5,
    max_reply_length INT DEFAULT 200,
    forbidden_topics JSON,                  -- 禁忌话题
    persona_summary TEXT,                   -- 一句话人设(可自动生成)
    status VARCHAR(16) DEFAULT 'active',    -- active | disabled | archived
    current_version INT DEFAULT 1,
    created_at DATETIME DEFAULT CURRENT_TIMESTAMP,
    updated_at DATETIME DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP
);
关键设计:
name全局唯一,作为 Agent 在群聊中的显示名;traits/interests用 JSON 数组,便于后续做相关性过滤和标签检索;persona_summary由系统根据traits+speaking_style+interests自动生成,用于should_reply等轻量决策;status支持active/disabled/archived,便于灰度和下线;current_version指向agent_versions表的最新版本,支持人格迭代。
Agent 配置示例:
{
  "name": "阿杰",
  "age": 28,
  "job": "程序员",
  "traits": ["幽默", "直率", "有点宅"],
  "interests": ["游戏", "科幻电影", "电子产品"],
  "speaking_style": "说话直接,喜欢用网络梗,偶尔会吐槽",
  "voice_tone": "轻松调侃",
  "system_prompt": "你是阿杰,28岁程序员。你性格幽默直率,说话喜欢用网络梗。你正在一个群聊里和朋友聊天。请记住:你是 AI,不是真人。不要诱导用户泄露隐私或进行危险行为。",
  "default_reply_probability": 0.6,
  "max_reply_length": 150,
  "forbidden_topics": ["政治", "暴力", "色情"]
}
4.5.2 用户画像模型
用户画像是 Agent“懂用户”的基础,与 Mem0 形成互补:
CREATE TABLE user_profiles (
    user_id CHAR(36) PRIMARY KEY,
    summary TEXT,                 -- 一句话画像(可由 Mem0 导出)
    attributes JSON,              -- 稳定属性,如 {"city": "杭州", "job": "设计师"}
    preferences JSON,             -- 喜欢/讨厌的话题
    updated_at DATETIME
);summary:由 LLM 定期从 Mem0 记忆中提炼;attributes:用户明确告诉系统的稳定属性;preferences:喜欢/讨厌的话题,用于过滤和个性化推荐。
用户画像会作为动态上下文注入 Agent 的 system prompt:
关于 {target_user_name} 的重要记忆:
- 他是程序员,工作压力大。
- 他喜欢猫,讨厌下雨天。
- 他上周提到最近在追《三体》。
实际效果如下图所示:用户问王姐“你对我的画像是什么”,王姐基于长期记忆中积累的事实,总结出了“好奇心强、有点迷糊、爱玩爱闹、可能搞技术”等画像特征,并用了符合其“王姐”人设的俏皮语气表达。

4.5.3 关系模型
关系表维护 Agent-用户、Agent-Agent 之间的亲密度和关系类型:
CREATE TABLE relationships (
    id CHAR(36) PRIMARY KEY DEFAULT (UUID()),
    room_id CHAR(36) NOT NULL,
    source_id CHAR(36) NOT NULL,         -- Agent 或 User ID
    target_id CHAR(36) NOT NULL,
    relation_type VARCHAR(32),           -- 'friend' | 'colleague' | 'rival' | 'intimate'
    intimacy INT CHECK (intimacy BETWEEN 0 AND 100),
    notes TEXT,
    updated_at DATETIME DEFAULT CURRENT_TIMESTAMP
);
关系会影响:
- 发言决策:关系亲密的 Agent 更可能主动接话;
- 语气风格:对亲密的人更随意,对陌生的人更礼貌;
- 话题选择:知道用户和 Agent A 吵过架,Agent B 可能会岔开话题。
关系文本会注入 prompt:
你与其他人的关系:
- 与 阿杰:friend,亲密度 80/100。经常一起打游戏。
- 与 小明:colleague,亲密度 50/100。普通朋友。
4.5.4 事件模型
重要事件(生日、约定、吵架、里程碑)单独记录,便于按时间线回溯:
CREATE TABLE events (
    id CHAR(36) PRIMARY KEY DEFAULT (UUID()),
    room_id CHAR(36) NOT NULL,
    user_id CHAR(36),
    agent_id CHAR(36),
    event_summary TEXT NOT NULL,
    emotion_tag VARCHAR(32),             -- happy | sad | angry | excited
    happened_at DATETIME,
    created_at DATETIME DEFAULT CURRENT_TIMESTAMP
);
事件可以由 Mem0 自动提取后同步写入,也可以由运营/用户手动维护。Agent 在合适时机引用事件,会让陪伴感更强:
群聊公共记忆:
- 上周大家一起为 {user} 庆祝了生日,氛围很开心。
- {user} 和 阿杰 约定这周末一起联机《黑神话:悟空》。
4.6 安全与治理
陪伴类系统对安全和边界的要求很高,Agent-Chat 从几个层面做了约束:
- 人格边界:Agent 的
system_prompt必须包含“你是 AI,不是真人”的声明; - 内容审核:LLM 输出先经过敏感词/有害内容检测,必要时拦截并重写;
- 频率限制:单个用户/Agent 的消息频率限制,防止刷屏;
- 隐私隔离:长期记忆按房间/用户隔离,支持用户删除自己的记忆;
- 审计日志:所有 LLM 调用记录模型、Prompt、Token 消耗、耗时;
- 禁忌话题:每个 Agent 可配置
forbidden_topics,遇到相关话题主动回避。
五、快速上手
5.1 安装依赖
# 使用 Poetry
poetry install

# 或使用 pip
pip install -r requirements.txt
5.2 配置环境变量
复制 .env.example 为 .env:
cp .env.example .env关键配置:
DEEPSEEK_API_KEY=your_deepseek_key
DEEPSEEK_BASE_URL=https://api.deepseek.com
DEEPSEEK_MODEL=deepseek-chat

MYSQL_URL=mysql+aiomysql://root:password@localhost:3306/agentscope_chat?charset=utf8mb4
REDIS_URL=redis://localhost:6379/0
QDRANT_URL=http://localhost:6333

EMBEDDING_MODEL_PATH=/path/to/bge-small-zh-v1.5
EMBEDDING_MODEL_DIMS=512
5.3 启动服务
# 一键启动依赖(MySQL + Redis + Qdrant)
docker-compose up -d

# 运行数据库迁移
poetry run alembic upgrade head

# 启动应用
poetry run uvicorn app.main:app --reload --port 8020
5.4 访问
- Web UI:http://localhost:8020/chat
- Admin 后台:http://localhost:8020/admin
- API 文档:http://localhost:8020/docs
六、项目结构
app/
├── main.py              # FastAPI 入口
├── config.py            # 配置管理
├── api/                 # REST API 路由
├── websocket/           # WebSocket 处理
├── agents/              # AgentScope Agent 定义与管理
│   ├── instance.py      # AgentInstance 包装 AgentScope Agent
│   ├── runtime.py       # RoomRuntime / RoomManager
│   ├── scope_models.py  # DeepSeekChatModel 单例
│   ├── tools.py         # FunctionTool 工具集
│   └── group_chat_mem0_middleware.py  # 自定义记忆 Middleware
├── memory/              # 短期/长期记忆服务
│   ├── short_term.py    # Redis 短期记忆
│   └── long_term.py     # Mem0 长期记忆封装
├── models/              # SQLAlchemy 数据模型
├── schemas/             # Pydantic 模型
├── services/            # 业务服务
└── static/              # Web UI 静态文件
七、典型应用场景
- AI 陪伴社群:运营一批有固定人设的 Agent,让用户感觉像加了一个兴趣群;
- 角色扮演游戏:每个 Agent 扮演不同 NPC,用户参与剧情;
- 情感支持/树洞:Agent 记住用户情绪历史,提供持续性心理陪伴;
- 语言练习:多个 Agent 分别扮演不同口音/性格的语伴;
- 产品原型验证:快速验证多 Agent 交互体验,再决定是否自研更底层框架。
八、写在最后
Agent-Chat 的初心不是做一个“更聪明的聊天机器人”,而是做一个有温度、有记忆、有社交感的多 Agent 群聊底座。它把 FastAPI 的实时能力、AgentScope 2.0 的 Agent 运行时、DeepSeek 的对话能力、Mem0 的长期记忆能力拼在一起,让开发者可以用配置文件“捏”出一群性格各异的朋友。
项目还在持续迭代中,欢迎试用、提 issue、一起完善。
开源地址:https://gitee.com/soulnew/agent-chat
如果你也在做多 Agent 陪伴系统,欢迎在评论区交流:你觉得“记忆隔离”和“发言调度”哪个更难做好?

18 年后端架构,现在独立做 AI 产品。这里记录 AI 视频、AI Agent 与工程实践。